HCCS 中心 5 篇论文入选 NeurIPS 2026!
近日,人工智能领域顶级会议 NeurIPS 2026(Conference on Neural Information Processing Systems)公布录用结果,Hopcroft 计算科学研究中心共有五篇论文被接收。这些工作沿着“表示学习 → 后训练对齐 → 具身感知”的脉络展开,涵盖视觉-语言预训练、CLIP 后训练、大语言模型零阶强化学习、扩散模型强化学习对齐,以及具身智能中的 3D 可供性感知。下面带大家快速了解这些工作。
01|ITO:训练时融合、推理零开销的图文预训练新框架
论文标题: ITO: Multi-View Alignment and Training-Time Fusion for Image-Text Pretraining
作者: Hanpeng Liu, Zidan Wang, Shuoxi Zhang, Zonglin Zhao, Zihao Bo, Rinyoichi Takezoe, Kaiwen Long, Yaqian Li, Kun He
单位: 华中科技大学、理想汽车、中国科学院
代码地址: showstarpro/ITO
研究动机
CLIP 式对比学习能够把成对的图像和文本拉近,但“对齐”并不等于“按语义组织”:在学到的表示空间里,图像嵌入和文本嵌入往往仍按模态各自聚成一团,存在明显的模态鸿沟。
核心方法
ITO 通过两个分工明确的机制解决这一问题:
- 多视角对齐(Multi-View Alignment): 让同一条文本对应多个增强后的图像视角,把一对一监督扩展为多对一监督,这是判别性能提升的主要来源。
- 训练时多模态融合(Training-Time Fusion): 引入轻量融合模块作为正则项,只在训练时使用,推理时直接丢弃。部署时模型仍保持标准双塔结构,推理成本与 CLIP 完全相同。
实验结果
研究在从百万到十亿级别的数据上验证了 ITO(CC3M → DataComp-1B):
- 中等数据规模下,ITO 超过 CLIP、SLIP、SigLIP、FLAIR 等强基线;在 100M–1B 规模下,相较于相同数据、骨干网络和训练设置的 CLIP 稳定领先。
- 线性探测最高提升 +7.9(YFCC15M),在 DataComp-1B 上提升 +1.6。
- 作为 LLaVA 的视觉编码器,在 VQAv2、GQA、MM-Vet、POPE 上全面优于 CLIP。
- 性能增益并非依赖额外堆叠算力: CLIP 训练 60 个 epoch 时,计算量已达 ITO 训练 30 个 epoch 的约 87%,但性能仍落后 7.0 个点。
- 融合模块的收益随数据规模增大而增大,并能够抑制对比学习训练后期的过拟合。
工作亮点: 训练时多模态融合,推理时零额外开销,在大规模图文预训练中实现稳定性能提升。
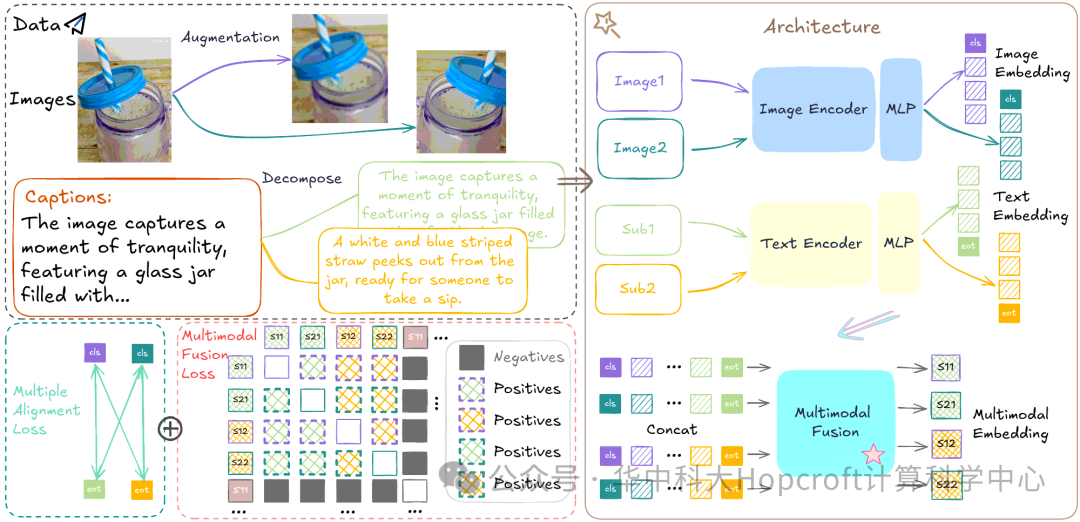
图1:ITO 框架
02|ComCLIP:重新审视 CLIP 后训练中的对比损失
论文标题: Rethinking Contrastive Loss in CLIP Post-training: A Complementary Framework with Frozen Text Encoder
作者: Zidan Wang, Yaqian Li, Xiaokai Zhang, Kaiwen Long, Kun He, Hanpeng Liu
单位: 华中科技大学、理想汽车
代码地址: showstarpro/ComCLIP
研究动机
已有工作认为,CLIP 后训练时 batch 较小,继续使用对比损失会导致灾难性遗忘,因此倾向于放弃对比损失。
但问题真的出在 batch size 上吗?
核心发现与方法
研究发现,遗忘的主要原因是温度系数 τ 设置不当,而不是 batch 太小。
只需将 τ 从 0.07 调整到 0.01,对比后训练就能反过来提升原模型的性能。
基于这一发现,研究提出 ComCLIP:冻结文本编码器,仅训练 1 个 epoch,联合使用三项目标精修视觉编码器:
- 小温度对比损失: 改善对比后训练的优化效果;
- MSE 锚定: 约束视觉特征不偏离原始 CLIP;
- DINOv2 关系蒸馏: 引入视觉特征之间的关系知识。
训练后的视觉编码器结构和推理开销均保持不变,可以即插即用地替换原有 CLIP。
实验结果
- 零样本分类: 与 CLIP-Refine 持平;
- 线性探测: 显著优于 CLIP-Refine,达到 48.99 vs 42.28;
- 多模态大模型迁移: 可直接接入 LLaVA-1.5-7B,无需重新对齐,不影响下游性能。
工作亮点: 仅需 1 个 epoch,通过重新设计对比损失与互补训练目标,实现 CLIP 视觉编码器的高效精修。
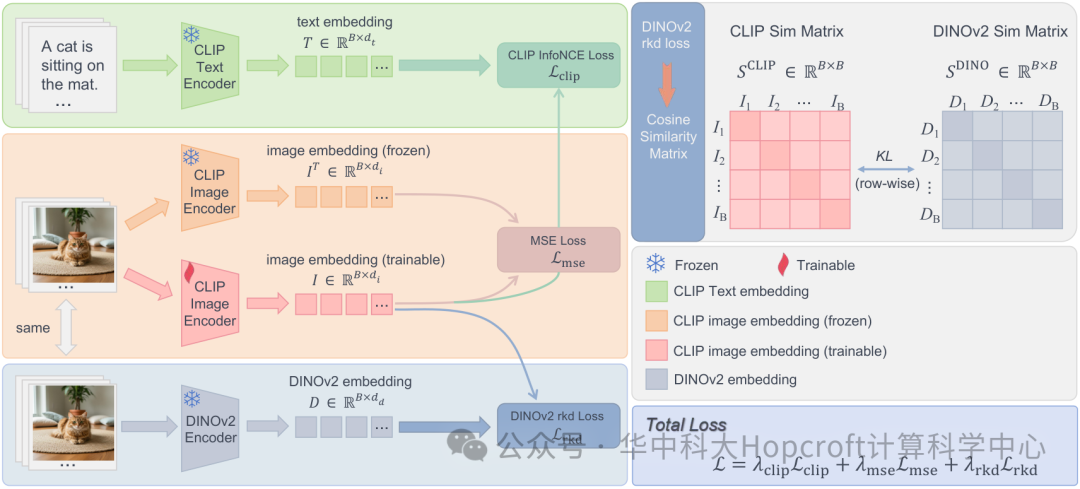
图2:ComCLIP 框架
03|ZO-BOLT:失配的代价——零阶强化学习中的噪声放大
论文标题: The Cost of Mismatch: Noise Amplification in Zeroth-Order Reinforcement Learning
作者: Lianmin Chen, Junbin Qiu, Chenxing Wei, Yao Shu, Kun He
单位: 华中科技大学、香港科技大学(广州)
研究动机
可验证奖励的强化学习(RLVR)已成为提升大语言模型推理能力的重要后训练范式,但主流一阶优化依赖反向传播,显存开销大。
零阶优化(ZOO)只需前向计算,可将训练显存降至接近推理的水平。
然而,现有大模型零阶优化研究主要集中在监督微调等固定数据场景。零阶优化在 RLVR 中是否可靠,仍缺少系统研究。
核心发现
零阶优化通过比较参数扰动前后的函数值差分估计梯度。
在同策略(on-policy)强化学习中,用于评估的数据由模型自己采样,而参数一旦被扰动,差分两端就必须各自独立采样。
这造成了数据失配(mismatched-data regime),进而引入 1/μ² 量级的噪声放大(μ 为扰动规模),严重削弱优化信号。
核心方法:ZO-BOLT
针对上述问题,研究提出 ZO-BOLT。
该方法将零阶优化应用于 BOLT 中与 RLVR 目标对齐的加权监督微调目标,使有限差分两端共享同一批数据,保证数据匹配(matched-data regime),从而避免失配带来的 1/μ² 噪声放大。
实验结果
- 机制验证: 受控实验通过估计噪声方差,直接验证数据失配下的 1/μ² 方差放大,而数据匹配下没有出现这一现象。
- 端到端验证: ZO-BOLT 和 ZO-GRPO 的数据匹配版本,均优于对应的数据失配版本。
- 数学推理表现: ZO-BOLT 在保持显存优势的同时,实现了有效的性能提升。
工作亮点: 揭示零阶强化学习中的数据失配与噪声放大机制,并通过数据匹配实现更稳定、高效的大模型后训练。
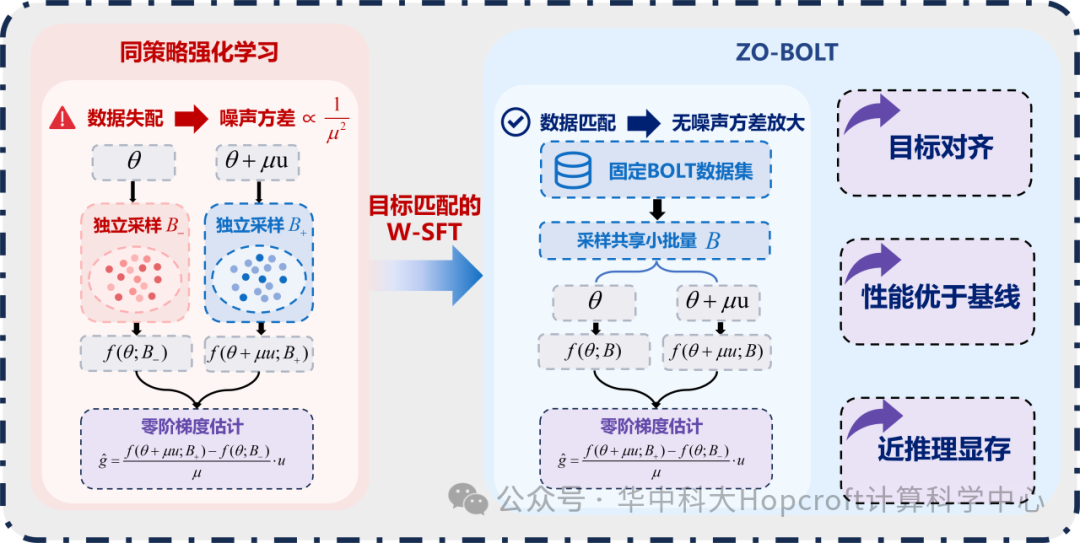
图3:ZO-BOLT 框架
04|TMPO:轨迹匹配策略优化,让扩散模型对齐既多样又高效
论文标题: TMPO: Trajectory Matching Policy Optimization for Diverse and Efficient Diffusion Alignment
作者: Jiaming Li, Chenyu Zhu, Nanxi Yi, Youjun Bao, Li Sun, Quanying Lv, Xiang Fang, Daizong Liu, Jianjun Li, Kun He, Bowen Zhou, Zhiyuan Ma
单位: 华中科技大学、快手、南洋理工大学、武汉大学、清华大学
论文地址: arXiv:2605.10983
代码地址: mair-lab-hust/tmpo
研究动机
强化学习已被广泛用于将扩散模型对齐到人类偏好等下游目标,但现有方法普遍存在奖励投机(reward hacking):生成结果逐渐集中到少数高奖励的“套路”上,出现视觉模式崩塌(Visual Mode Collapse),多样性和质量双双下降。我们认为,问题的根源在于这些方法“只追求最大化期望奖励”的模式寻求(mode-seeking)特性——它没有约束策略在所有可接受轨迹上的概率分布。
方法
TMPO 将对齐目标从“最大化标量期望奖励”转变为“轨迹级奖励分布匹配”:
- Softmax 轨迹平衡(Softmax-TB)目标: 让 K 条采样轨迹的策略概率去匹配由奖励诱导的 Boltzmann 分布,无需估计复杂的全局配分函数。理论上,该目标继承了前向 KL 散度的模式覆盖(mode-covering)性质,能在优化奖励的同时保持对各类可接受结果的覆盖。
- 动态随机树采样(Dynamic Stochastic Tree Sampling): 多条轨迹共享去噪前缀,只在动态调度的步数处分叉,大幅减少多轨迹训练中的冗余计算。
实验结果
- 在 FLUX.1-dev 和 SD3.5-Medium 上,覆盖人类偏好、组合生成、文字渲染等多种对齐任务;
- 生成多样性相比当前最优方法提升 9.1%,各项下游指标保持竞争力,取得奖励与多样性的最佳权衡;
- 借助动态随机树采样,单次训练迭代时间缩短近 40%。
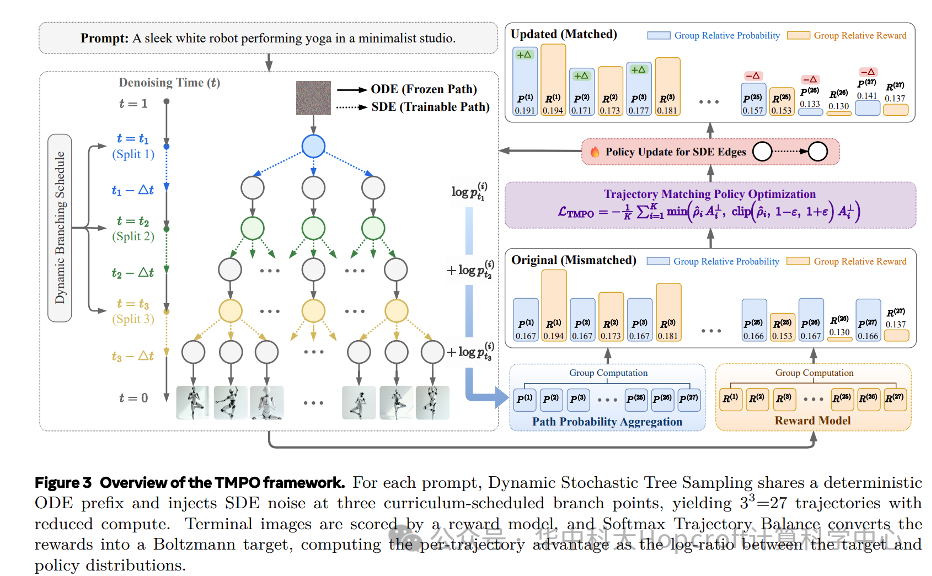
图4:TMPO 框架
05|VideoAfford:从人-物交互视频中定位 3D 可供性
论文标题: VideoAfford: Grounding 3D Affordance from Human-Object-Interaction Videos via Multimodal Large Language Model
作者: Hanqing Wang¹, Mingyu Liu², Xiaoyu Chen¹, Chengwei Ma¹, Yiming Zhong³, Wenti Yin⁴, Yuhao Liu⁵, Zhiqing Cui¹, Jiahao Yuan¹, Lu Dai¹˒⁶, Zhiyuan Ma⁴˒†, Hui Xiong¹˒⁶˒†(† 通讯作者)
单位: ¹香港科技大学(广州) ²浙江大学 ³上海科技大学 ⁴华中科技大学 ⁵山东大学 ⁶香港科技大学
论文地址: arXiv:2602.09638
代码地址: HKUST-GZ-CVL/VideoAfford
研究动机
机器人要“会用”物体,首先得知道物体的哪些部位可以被怎样使用,即 3D 可供性定位(3D Affordance Grounding)。
设想观看一段“人拿起杯子喝水”的完整视频:我们不仅能看到手抓在哪里,还能理解动作的力度、轨迹,以及杯子在空间中的功能属性。
从动态交互中理解物体的“可利用性”,正是机器人走向智能操作的关键能力。
主要贡献
- 构建大规模数据集: 提出首个大规模视频驱动的 3D 可供性数据集 VIDA。
- 提出 VideoAfford 框架: 借助多模态大语言模型,利用视频中的动态交互信息,精准定位 3D 空间中的可供性区域。
- 探索具身智能操作: 该工作也是团队面向交互式 VLA 操作方向的首个铺垫性工作。
工作亮点: 从静态物体感知走向动态交互理解,为机器人学习物体功能与智能操作提供新的研究路径。
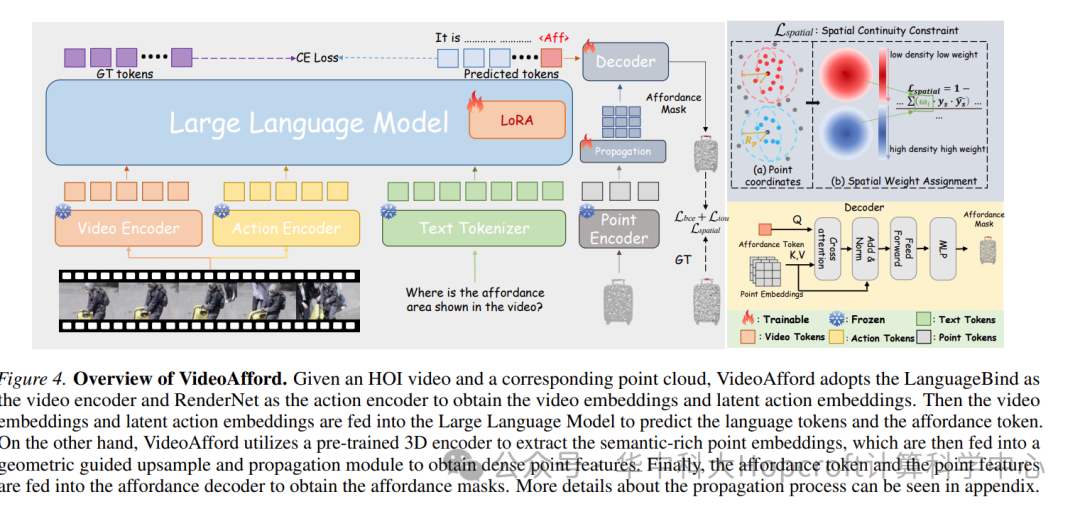
图5:VideoAfford 框架
结语
以上五项工作覆盖了视觉-语言表示学习、大语言模型与生成模型的强化学习对齐,以及具身智能感知等多个方向。欢迎大家阅读论文、试用代码、交流讨论!
关注 HCCS 中心公众号,获取更多前沿科研成果与学术动态!
原文来源:华中科大 Hopcroft 计算科学中心:HCCS 中心 5 篇论文入选 NeurIPS 2026!(2026 年 10 月 9 日)